Mencari dan Membaca Web
Buka di CMSAgent Anda menjawab pertanyaan dari knowledge base yang Anda berikan. Tetapi kadang informasi yang dibutuhkan user tidak ada di dokumen Anda. Informasi itu ada di internet terbuka, atau di website yang sering berubah. Fitur Web Search dan Web Scraping memungkinkan agent Anda menjangkau lebih jauh dari knowledge base-nya dan membaca konten live dari web selama percakapan.
Dalam tutorial ini Anda mengatur kedua fitur untuk Atlas, asisten operasional Kirana Group. Site supervisor dan staf keselamatan Kirana sering bertanya tentang panduan keselamatan publik, misalnya dari UK Health and Safety Executive (HSE). SOP Kirana tidak mencakup setiap detail, dan panduan resmi berubah dari waktu ke waktu. Jadi Anda mengizinkan Atlas mencari di web, tetapi hanya di sumber resmi: hse.gov.uk dan ilo.org.
Apa Itu Web Search?
Web Search memungkinkan agent Anda melakukan pencarian internet secara real-time selama percakapan. Saat user menanyakan sesuatu yang tidak bisa dijawab agent dari knowledge base-nya, agent mengirim query ke mesin pencari, mendapatkan daftar hasil yang sudah diurutkan, lalu memakainya untuk menyusun jawaban yang berdasar dan terkini. Semua ini terjadi dalam giliran chat yang sama.
Bayangkan agent Anda punya mesin pencari yang ia konsultasikan sendiri, tanpa user perlu meninggalkan percakapan.
Kapan memakai Web Search
- Agent Anda perlu menjawab pertanyaan tentang hal yang berubah seiring waktu, seperti regulasi publik, panduan, atau harga
- Anda ingin mengurangi pekerjaan menjaga knowledge base tetap mutakhir
- Agent Anda menangani topik yang luas dan Anda tidak bisa mengantisipasi setiap pertanyaan
Apa Itu Web Scraping?
Web Scraping melangkah lebih jauh. Alih-alih daftar cuplikan hasil pencarian, fitur ini mengambil seluruh konten halaman web tertentu dan mengubahnya menjadi markdown yang bersih dan mudah dibaca. Agent lalu memakai konten itu untuk menjawab pertanyaan user secara detail.
Ini berguna saat user membagikan URL, atau saat agent perlu membaca halaman yang sebenarnya (halaman panduan, artikel berita, halaman dokumentasi), bukan sekadar tahu bahwa halaman itu ada.
Kapan memakai Web Scraping
- User membagikan URL dan berharap agent merangkum atau menjawab pertanyaan tentang halaman tersebut
- Anda ingin agent membaca teks lengkap sebuah halaman, bukan hanya cuplikan hasil pencarian
- Agent Anda perlu memproses halaman terstruktur seperti dokumentasi, spesifikasi, atau halaman panduan
Perbandingan Kedua Fitur
| Web Search | Web Scraping | |
|---|---|---|
| Yang diambil | Daftar cuplikan hasil dari mesin pencari, sudah diurutkan | Seluruh konten teks dari halaman web tertentu |
| Dipicu oleh | Pertanyaan yang tidak bisa dijawab agent dari knowledge base-nya | URL yang dibagikan dalam percakapan, atau kebutuhan akan konten satu halaman penuh |
| Format output | Ringkasan hasil pencarian | Konten halaman dalam format markdown |
| Pembatasan domain | Izinkan hingga 20 domain | Abaikan path atau tipe file tertentu |
| Penanganan gambar | Tidak berlaku | Filter ukuran yang bisa diatur |
| Paling cocok untuk | Pertanyaan faktual real-time | Membaca satu halaman tertentu secara mendalam |
Kedua fitur bisa aktif bersamaan, dan keduanya saling melengkapi.
Web Search atau Website di Knowledge? Di Websites Anda mengindeks satu halaman HSE ke knowledge base Atlas sebelumnya. Itu pilihan yang tepat untuk halaman yang Anda tahu akan dibutuhkan user. Web Search menangani pertanyaan yang tidak Anda antisipasi, dan selalu membaca versi terbaru dari sumbernya.
Manfaat
Manfaat Web Search
- Selalu terkini: agent menemukan informasi terbaru tanpa perlu memperbarui knowledge base secara manual
- Cakupan lebih luas: menangani pertanyaan di luar cakupan dokumen yang Anda kurasi
- Sumber yang transparan: jawaban bisa menyebutkan dan menautkan halaman asal informasinya
- Filter domain: Anda bisa membatasi pencarian hanya ke domain tepercaya, agar jawaban tetap andal
Manfaat Web Scraping
- Pemahaman konten penuh: agent membaca halaman yang sebenarnya, bukan hanya ringkasannya
- Percakapan yang mengenali URL: user bisa menempelkan link dan langsung meminta agent menjelaskan atau merangkumnya
- Presisi markdown: konten diekstrak sebagai teks terstruktur yang bersih, dengan lebih sedikit gangguan dari iklan dan navigasi
- Kontrol gambar: Anda bisa menyertakan atau mengecualikan gambar dan memfilternya berdasarkan ukuran file
Risiko dan Pertimbangan
Catatan: Kedua fitur mengirim request keluar ke website eksternal selama percakapan. Pahami konsekuensinya sebelum mengaktifkannya untuk user sungguhan.
Risiko Web Search
| Risiko | Keterangan |
|---|---|
| Sumber yang tidak akurat | Hasil pencarian bisa memuat halaman dengan informasi yang salah atau usang. Kurangi risikonya dengan hanya mengizinkan domain tepercaya. |
| Hasil yang tidak relevan | Tanpa daftar domain, agent bisa memakai konten yang tidak ada hubungannya dengan kebutuhan Anda. |
| Latensi | Setiap pencarian menambah satu perjalanan jaringan ke waktu respons. Jaga Max Web Search Results tetap rendah dan pilih Search Depth yang lebih dangkal untuk menekannya. |
| Kebocoran data | Query user dikirim ke mesin pencari. Hindari mengaktifkan Web Search untuk agent yang menangani informasi rahasia atau data pribadi. |
Risiko Web Scraping
| Risiko | Keterangan |
|---|---|
| Ketentuan layanan | Sebagian website melarang scraping otomatis. Pastikan situs yang dibaca agent Anda mengizinkannya. |
| Konten dinamis | Halaman yang sepenuhnya dibangun dengan JavaScript mungkin tidak selesai dirender dalam batas timeout. |
| Payload berlebihan | Halaman besar dengan banyak gambar bisa memperlambat respons. Pakai filter ukuran gambar dan path yang diabaikan untuk mengatur apa yang diambil. |
| Paparan konten sensitif | Jika user memberikan URL ke halaman internal atau sensitif, agent mencoba membacanya. Pertimbangkan audiens Anda sebelum mengaktifkan fitur ini. |
Sebelum memulai
- Anda sudah punya agent. Jika belum, ikuti Membuat Agent Pertama Anda terlebih dahulu.
- Agent Anda sudah menjawab dengan baik dari sumbernya sendiri. Selesaikan dulu Mengajari Agent Anda, agar web mengisi celah, bukan menggantikan knowledge base Anda. Untuk Atlas, artinya SOP-FIN-007 dan halaman HSE tentang tangga sudah ada di Knowledge.
- Anda tahu cara menguji dan mem-publish perubahan. Lihat Preview dan Publish Perubahan.
- Anda sign in sebagai Owner atau Contributor agent tersebut. Viewer tidak bisa membuka setelan ini.
- Anda sudah membuka agent (Atlas) dari daftar agent, sehingga agent itu menjadi agent yang aktif.
Bagian 1: Mengatur Web Search
Langkah 1: Buka halaman Web Search
Di sidebar kiri, buka Tools lalu klik Web Search.
Halaman ini punya dua bagian: Web Search Configuration dan Domain Whitelist.
Langkah 2: Aktifkan Web Search dan tentukan seberapa banyak ia mencari
Di Web Search Configuration, atur kontrolnya seperti ini untuk Atlas:
| Kontrol | Nilai untuk Atlas | Fungsinya |
|---|---|---|
| Enable Web Search | Aktif | Memungkinkan agent mencari dan mengambil informasi dari internet secara real-time. Secara default nonaktif. |
| Max Web Search Results (wajib) | 3 | Berapa banyak hasil pencarian yang diambil agent per query. Default-nya 3. |
| Search Depth | Balanced | Seberapa menyeluruh setiap query dicari. |
| Allow User Control | Nonaktif (bertanda Coming Soon) | Nantinya memungkinkan user menyalakan atau mematikan web search selama percakapan. Belum bisa diaktifkan. |
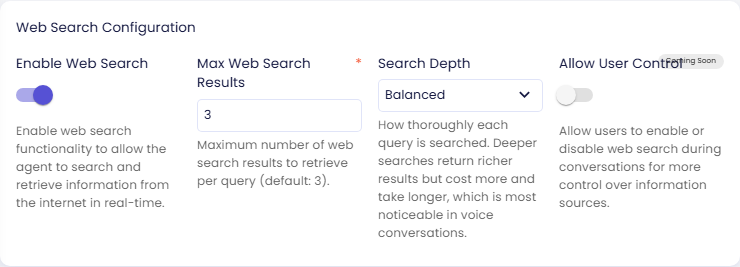
Max Web Search Results menukar kecepatan dengan konteks:
| Nilai | Efek |
|---|---|
1 | Respons paling cepat, tetapi konteks untuk agent terbatas |
3 (default) | Keseimbangan yang baik antara kecepatan dan kualitas jawaban |
| Nilai lebih tinggi | Konteks lebih kaya, tetapi respons lebih lambat karena data yang diambil bertambah |
Untuk sebagian besar agent, pertahankan antara 3 dan 5.
Search Depth menentukan seberapa keras pencarian berusaha. Max Web Search Results menentukan berapa banyak halaman yang kembali; Search Depth menentukan seberapa menyeluruh setiap query dikerjakan.
| Depth | Efek |
|---|---|
| Fast | Latensi dan biaya paling rendah. Paling cocok untuk agent yang sering mencari, dan untuk percakapan voice, tempat jeda jauh lebih terasa dibanding di chat |
| Balanced (default) | Pencarian memilih strateginya sendiri per query. Titik awal yang masuk akal untuk sebagian besar agent |
| Deep | Paling menyeluruh dan paling mahal. Cocok untuk agent bergaya riset, tempat kelengkapan lebih penting daripada kecepatan |
Pencarian yang lebih dalam lebih mahal per query, dan biayanya dibebankan ke credit organization Anda. Jika agent Anda mencari di hampir setiap giliran, mulailah dari Fast atau Balanced dan pindah ke Deep hanya jika jawabannya memang kurang memadai.
Tip: Untuk mencoba fitur ini tanpa memengaruhi user sungguhan, uji dulu di preview sebelum mem-publish. Perubahan Anda tetap berupa draft sampai Anda mengklik Publish.
Langkah 3: Izinkan hanya domain resmi
Secara default, Web Search mencari di seluruh internet. Untuk Atlas, jawaban keselamatan harus berasal dari sumber resmi, jadi Anda membatasi pencarian di Domain Whitelist.
- Di bawah Allowed Domains, klik Add New Domain.
- Ketik
hse.gov.uk. - Klik Add New Domain lagi dan ketik
ilo.org.
Masukkan setiap domain tanpa http:// atau https://:
| ✅ Format yang benar | ❌ Format yang salah |
|---|---|
hse.gov.uk | https://www.hse.gov.uk/ |
ilo.org | http://ilo.org |
Nama domain harus mengandung setidaknya satu titik dan hanya memakai huruf, angka, tanda hubung, garis bawah, dan titik. Anda bisa menambahkan hingga 20 domain. Jika daftar berisi entri, agent hanya mencari di domain tersebut. Biarkan kosong untuk mengizinkan semua domain.
Untuk menghapus domain, klik ikon hapus merah di sebelah kanannya.
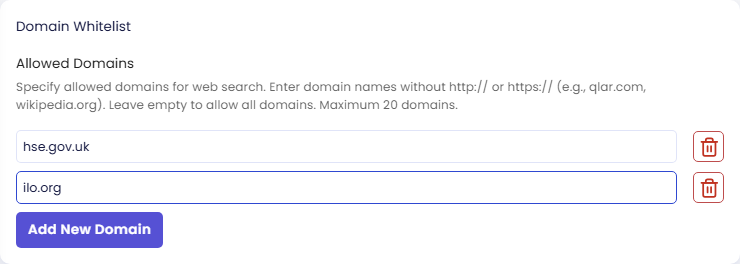
Tip: Mulailah dengan dua atau tiga sumber yang otoritatif. Anda bisa menambahkannya nanti. Daftar pendek yang dikurasi sangat mengurangi kemungkinan agent mengutip konten yang tidak akurat atau tidak relevan.
Langkah 4: Simpan
Klik Save di bagian bawah halaman. Perubahan Anda disimpan sebagai draft: Anda bisa langsung mencobanya di preview, dan user sungguhan mendapatkannya setelah Anda mengklik Publish.
Bagian 2: Mengatur Web Scraping
Langkah 1: Buka halaman Web Scraping
Di sidebar kiri, masih di bawah Tools, klik Web Scraping.
Halaman ini punya tiga bagian: Web Scraping Configuration, Image Size Filters, dan Ignored Paths.
Langkah 2: Aktifkan Web Scraping
Di Web Scraping Configuration, atur kontrolnya seperti ini untuk Atlas:
| Kontrol | Nilai untuk Atlas | Fungsinya |
|---|---|---|
| Enable Web Scraping | Aktif | Memungkinkan agent mengekstrak dan menganalisis konten halaman web secara real-time. |
| Include Images | Nonaktif | Jika aktif, gambar disertakan dalam output markdown. Jika nonaktif, semua gambar dibuang dari konten hasil scraping. Atlas hanya butuh teks halaman panduan. |
| Timeout (seconds) (wajib) | 30 | Waktu maksimum menunggu halaman selesai dimuat. Default-nya 30 detik. |
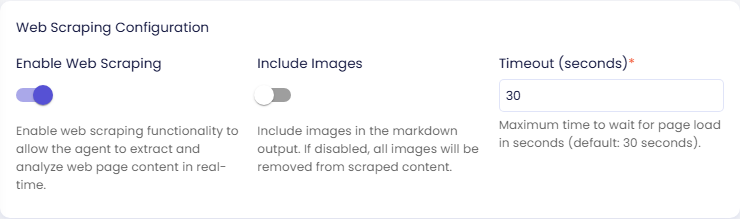
Timeout harus antara 5 dan 60 detik:
| Skenario | Nilai yang disarankan |
|---|---|
| Halaman cepat yang didominasi teks (dokumentasi, panduan) | 15 sampai 20 |
| Halaman standar | 30 (default) |
| Halaman berat dengan banyak resource | 45 sampai 60 |
Timeout yang terlalu rendah menyebabkan pengambilan sebagian atau gagal pada halaman yang lebih lambat. Timeout yang terlalu tinggi membuat agent menunggu lebih lama saat halaman tidak bisa dijangkau.
Tip: Jika gambar tidak penting untuk kebutuhan Anda, biarkan Include Images nonaktif. Ini cara paling efektif untuk mempercepat web scraping.
Langkah 3: Periksa filter ukuran gambar
Image Size Filters menentukan gambar mana yang dipertahankan saat Include Images aktif. Gambar di luar rentang ini disaring. Atlas menonaktifkan gambar, jadi biarkan nilai default-nya:
- Min Image Size (KB) (wajib):
5. Gambar yang lebih kecil, seperti ikon dan dekorasi, disaring. - Max Image Size (MB) (wajib):
10. Gambar yang lebih besar disaring agar tidak terjadi unduhan berlebihan.
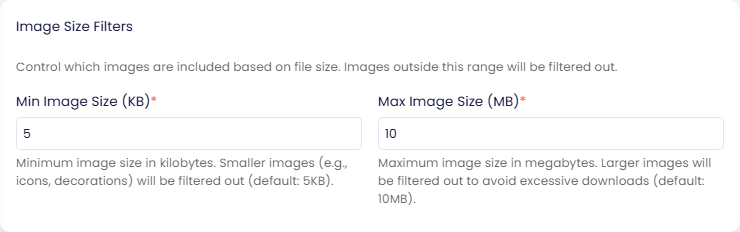
| Setelan | Minimum | Maksimum | Default |
|---|---|---|---|
| Min Image Size | 1 KB | 10.240 KB (10 MB) | 5 KB |
| Max Image Size | 1 MB | 50 MB | 10 MB |
Langkah 4: Abaikan path yang tidak diperlukan
Ignored Paths berisi pola yang dilewati scraper. Situs keselamatan resmi menautkan banyak leaflet PDF, yang lambat diambil dan tidak diperlukan untuk jawaban singkat. Jadi untuk Atlas Anda melewati file PDF:
- Di bawah Path Patterns to Ignore, klik Add New Path Pattern.
- Ketik
*.pdf.
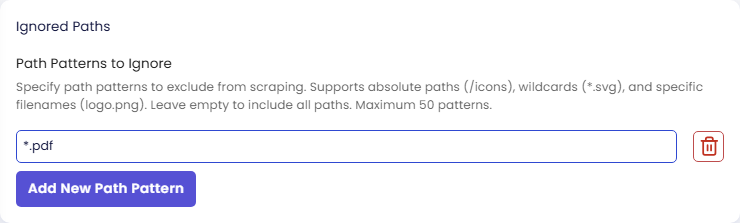
Setiap pola bisa berbentuk salah satu dari berikut:
| Jenis pola | Contoh | Yang dikecualikan |
|---|---|---|
| Path absolut | /icons | Semua konten di bawah path /icons/ |
| Wildcard berdasarkan ekstensi | *.svg | Semua file SVG, apa pun path-nya |
| Nama file tertentu | logo.png | File apa pun yang bernama logo.png |
Anda bisa menambahkan hingga 50 pola, masing-masing maksimal 200 karakter. Biarkan daftar kosong untuk menyertakan semua path. Untuk menghapus pola, klik ikon hapus di sebelah kanannya.
Tip: Pola yang umum diabaikan:
*.svg,*.ico,*.woff,*.woff2,/cdn-cgi,/wp-content/uploads. Biasanya ini aset yang tidak perlu dibaca agent.
Langkah 5: Konfirmasi dan simpan
Klik Save di bagian bawah halaman.
Berbeda dengan Web Search, Web Scraping menampilkan dialog konfirmasi sebelum menerapkan setelan Anda. Tinjau ringkasannya lalu klik Confirm. Langkah tambahan ini ada karena setelan ini mengubah cara agent memproses konten eksternal, yang memengaruhi kualitas jawaban dan latensi.
Setelan baru disimpan sebagai draft. User sungguhan mendapatkannya setelah Anda mengklik Publish.
Memakai Kedua Fitur Bersamaan
Web Search dan Web Scraping bekerja secara terpisah, tetapi saling melengkapi:
- User menanyakan sesuatu yang tidak bisa dijawab agent dari knowledge base-nya.
- Web Search menemukan halaman yang paling relevan di domain yang diizinkan.
- Web Scraping mengambil seluruh konten dari hasil teratas.
- Agent menyusun jawaban yang detail dan bersumber dari teks halaman lengkap.
Mengaktifkan keduanya memberi agent Anda akses seluas mungkin ke informasi live, tetapi masing-masing menambah latensi dan ketergantungan pada pihak eksternal. Mulailah dengan Web Search saja, ukur dampaknya pada waktu respons, lalu tambahkan Web Scraping saat Anda butuh pembacaan yang lebih dalam.
Kesalahan Umum yang Perlu Dihindari
| Kesalahan | Mengapa penting | Solusi |
|---|---|---|
| Membiarkan Allowed Domains kosong dalam konteks bisnis | Agent bisa mengutip sumber yang tidak andal | Tambahkan daftar kurasi berisi 2 sampai 5 domain tepercaya |
| Mengatur Max Web Search Results di atas 5 | Nilai lebih tinggi menambah latensi secara nyata | Pertahankan di 3 sampai 5 kecuali kedalaman sangat penting |
| Mengaktifkan Include Images tanpa filter ukuran | Gambar besar memperlambat ekstraksi | Atur Max Image Size (MB) ke 2 sampai 5 untuk pemakaian umum |
| Memakai timeout di bawah 10 detik | Timeout yang pendek sering menyebabkan scraping gagal | Pakai 20 sampai 30 detik sebagai patokan |
| Mengaktifkan Web Scraping untuk percakapan rahasia | User bisa membagikan URL apa pun, termasuk halaman internal | Aktifkan scraping hanya jika audiens dan kontennya sesuai |
| Tidak menguji setelah konfigurasi | Setelan mungkin tidak bekerja seperti yang diharapkan di semua situs | Uji dengan 3 sampai 5 pertanyaan atau URL yang representatif sebelum mem-publish |
Periksa hasilnya
-
Buka panel preview di sisi kanan CMS dan klik tombol reload untuk memulai percakapan baru.
-
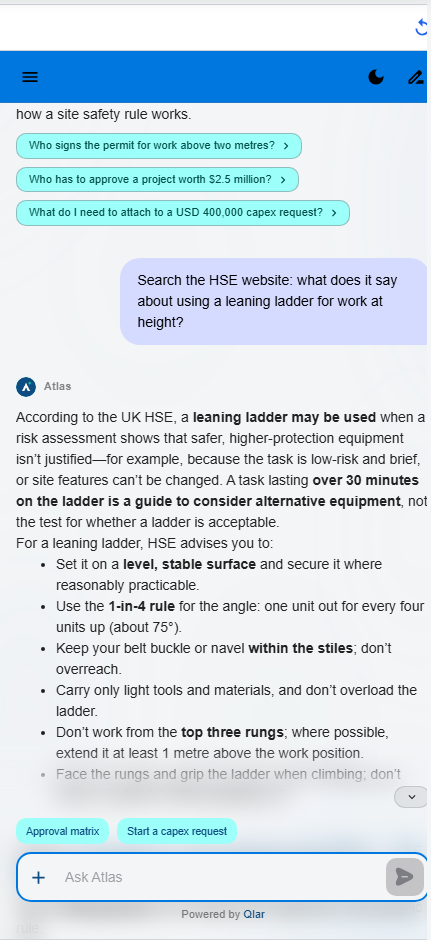
Ajukan pertanyaan yang tidak dijawab SOP Kirana dan dicakup oleh domain yang diizinkan. Contoh chat tetap dalam bahasa Inggris, sesuai screenshot:
Search the HSE website: what does it say about using a leaning ladder for work at height? -
Atlas menjawab dari panduan HSE: leaning ladder boleh dipakai jika risk assessment menunjukkan bahwa peralatan yang lebih aman dan berproteksi lebih tinggi tidak dibenarkan, misalnya untuk tugas singkat yang berisiko rendah. Lalu Atlas mencantumkan saran HSE, seperti meletakkan tangga di permukaan yang rata dan stabil, memakai 1-in-4 rule untuk sudutnya (satu satuan ke luar untuk setiap empat satuan ke atas, sekitar 75°), menjaga gesper sabuk tetap di antara stile, dan tidak bekerja dari tiga anak tangga teratas.
-
Gulir ke bawah di jawaban. Atlas menyebutkan halaman HSE yang dipakainya dan menegaskan bahwa ini panduan HSE, bukan SOP Kirana.
Jika jawabannya tidak sesuai:
- Atlas mengatakan tidak bisa menemukan informasinya. Periksa bahwa Enable Web Search aktif dan Anda sudah mengklik Save. Lalu tanyakan lagi di percakapan baru.
- Atlas mengutip situs yang tidak ada di daftar Anda. Periksa ejaan domain di Allowed Domains (tanpa
https://, tanpa garis miring di akhir). - Atlas menjawab dari knowledge base-nya. Itu wajar jika knowledge base mencakup pertanyaannya. Tanyakan sesuatu yang tidak ada di dokumen Anda, atau awali pertanyaan dengan "Search the HSE website".
Jika Anda sudah puas dengan jawabannya, klik Publish agar user sungguhan mendapatkan perubahan tersebut. Lihat Preview dan Publish Perubahan.
Langkah berikutnya
- Berikutnya dalam jalur ini: Menghubungkan API Anda, agar Atlas bisa memeriksa status proyek di sistem Kirana sendiri.
- Menggunakan Plugin: perluas agent Anda dengan plugin siap pakai untuk operasi umum.
- Analitik & Log: lihat bagaimana agent Anda memakai konten web dalam percakapan nyata.